2026年9月30日,DeepSeek 宣布开源面向华为昇腾算力平台的一整套基础设施组件,包括 TileLang 高级语言编译工具、DeepGEMM、DeepEP、TileKernels、FlashMLA 和 DeepSelect。据 DeepSeek 方面及多家媒体报道,这六项组件与其此前在英伟达平台上开源的版本在接口层面一一对应,并围绕昇腾 950 的 128 卡超节点方案做了计算与通信优化。
这件事的分量不在模型,而在工程栈。模型能力没有变化,变的是同一套训练与推理代码能不能换一块芯片跑起来。对长期被 CUDA 生态锁定的国产算力来说,这是补底层内核的一步;但截至目前,公开信息基本来自官方公告与媒体转述,实际性能、适配覆盖面和迁移工作量仍缺少第三方验证。
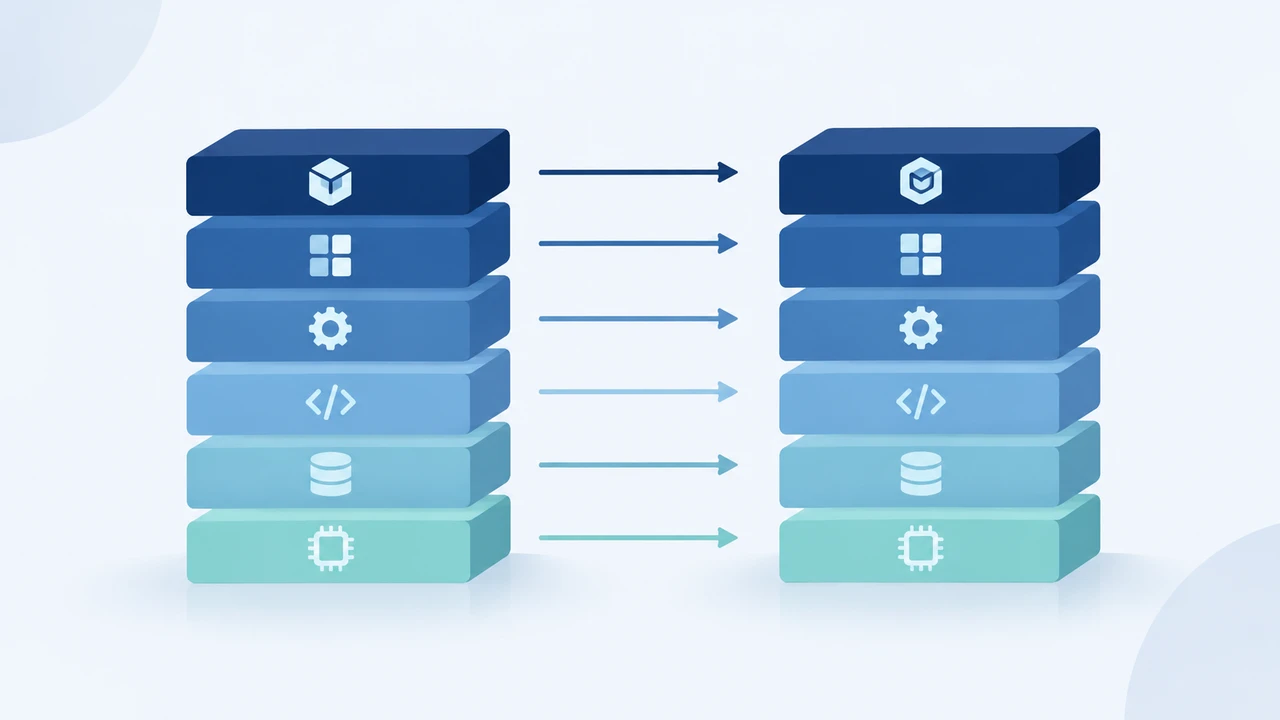
六项组件分别卡在栈的哪一层
把六项组件按职责归类,比逐项罗列更容易看清它们补的是什么位置。
| 层次 | 组件 | 承担的工作 | 对应英伟达侧 |
|---|---|---|---|
| 编程与编译 | TileLang | 用类 Python 的 DSL 描述分块与访存策略,编译到昇腾 Ascend C / PTO ISA | TileLang 的 CUDA 后端 |
| 矩阵算子 | DeepGEMM | MoE 与稠密负载的矩阵乘,覆盖 FP8、FP4、BF16 精度 | DeepGEMM |
| 常规算子 | TileKernels | 向量计算与访存类算子 | TileKernels |
| 通信库 | DeepEP | 专家并行的 All-to-All Token 分发与聚合,基于 Ascend C、HCCL、UBMEM | DeepEP |
| 注意力内核 | FlashMLA | DeepSeek V3/V4 系列使用的注意力算子 | FlashMLA |
| 数据侧算子 | DeepSelect | 训练数据筛选 | DeepSelect |
这套划分对应大模型实际运行时的四条关键路径:算子怎么写出来、矩阵乘跑得多快、多卡之间怎么通信、注意力这一最耗时的环节怎么压。缺任何一环,另一块芯片上的“能跑”都会退化成“跑得慢”或“跑不稳”。
其中 TileLang 的位置最特殊。它由北京大学计算机学院团队主导开发,2025 年 1 月开源,定位是连接算法与硬件的中间层。按 DeepSeek 的说法,TileLang 的编程比 CUDA 简单,能提高开发效率,同时编程模型可以贴近芯片特性;目前 DeepSeek V4 系列模型训练中的大部分算子已由 TileLang 承载。这句话的信息量在于:它不是演示性工具,而是生产环境里真正在用的那一层。
国产算力长期缺的不是芯片指标,是这一层
过去几年,国产 AI 芯片的硬件参数不断上探,但企业换芯时遇到的阻力往往不在峰值算力,而在软件栈。一家公司把训练代码从 CUDA 搬到另一套硬件,通常要重写大量自定义算子、重新调通信、重新标定精度,任何一处没对齐,吞吐就可能掉到不可接受的水平。这部分工作既不出现在论文里,也很难被采购清单量化,却直接决定了迁移的性价比。
DeepSeek 与昇腾的协同并非从这次开始。2025 年 9 月发布 V3.2-Exp 时,DeepSeek 首次同步开源 TileLang 版本算子,昇腾同日完成适配;2026 年 4 月 V4 预览版发布,华为云宣布在昇腾平台首发适配。此次开源把合作从“某个模型的某批算子”推进到“整套基础设施组件”,性质上更接近把一条已经跑通的生产链路整体搬到另一套硬件上。
配套的硬件方案也被一并披露。华为向 DeepSeek 提供了联合定义的昇腾超节点 SuperPoD Flex 与 UBL128 组网方案,官方描述为可支持 128 卡 3.2Tbps 单层交换的 Scale-up 网络,以及 256K 卡两层交换的 Scale-out 网络。这类细节值得注意,因为它意味着通信库的性能表现与特定组网形态绑定,脱离该形态的实际效果需要单独测量。
“一一对应”能说明什么,不能说明什么
接口层面对齐,解决的是开发者的学习成本和代码改造成本:同一套分块策略、同一套通信原语、同一套算子调用方式,在两个平台上写法接近,迁移时改动量可控。这对企业内部维护双栈、或者在不同供应商之间做备份方案,是实打实的便利。
但“对应”不等于“等价”。至少有三件事无法从公告中读出。
其一,性能。官方表述中出现了“逼近硬件极限性能”“达到硬件性能上限”一类说法,但这些是发布方口径,目前没有看到独立第三方在公开基准上的复现数据,也没有跨模型、跨集群规模的对比。
其二,覆盖率。一套算子库能否支撑一个企业的全部负载,取决于它没有覆盖的部分会退回什么路径。退回逐元素实现和退回高度优化内核,性能差距可能是数量级的。
其三,稳定性与维护节奏。六个项目均处于活跃更新阶段,部分能力仍在完善中,这一点在开发者社区的讨论中已有提及。与 CANN 版本的兼容矩阵、issue 响应速度、上游变更频率,都会在真实项目里变成成本。
企业评估迁移时该问的几个问题
如果一家公司正在考虑把部分训练或推理负载迁到昇腾,下面几个问题比“支持不支持”更有用。
- 你的模型结构落在已适配算子的哪一段? Transformer 主干之外的稀疏结构、自定义归一化、特殊位置编码,往往是回落最多的地方。要求给出算子覆盖率与回落比例的实测,而不是功能清单。
- 精度路径是否一致? FP8、FP4 在昇腾上的支持范围、缩放因子处理方式、数值误差表现,需要在自己的模型上跑通收敛对比,而不是只看是否“支持”。
- 性能基线在什么集群规模上取得? 128 卡超节点与 8 卡、16 卡小集群的通信行为差异很大。若你的集群规模不在官方优化范围内,需要单独压测 All-to-All 的实际带宽与尾延迟。
- 通信库对组网方案的依赖有多强? DeepEP 的优化建立在 HCCL 与 UBMEM 之上,换一种拓扑或交换机配置后还剩多少收益,要问清楚。
- 双栈维护的长期成本是多少? 接口对齐降低了初次迁移成本,但两套硬件并行意味着两套 CI、两套性能回归、两套故障排查经验。
- 退出成本有多高? 如果一年后要换回或换向第三家国产芯片,代码里有多少部分会被特定 API 绑定。
后续值得盯的三个观察点
第一,第三方性能复现。有没有独立团队在公开模型、公开数据集上给出吞吐、MFU、线性度扩展曲线,并与同规模英伟达方案做同口径对比。这是把“官方口径”变成“可采购依据”的关键一步。
第二,非 DeepSeek 模型的适配情况。这六项组件带着明显的自家模型印记,FlashMLA 直接对应 DeepSeek 的注意力结构。其他架构的模型能否同样受益,决定了它是“一家公司的生产栈开源”还是“一个平台的基础设施”。
第三,生态侧的跟进密度。如果围绕 TileLang 出现第三方算子库、教学材料和工具链插件,说明开发者真的在用;如果一年后提交仍主要来自原团队,那这次开源的象征意义会大于工程意义。
对关注国产算力的开发者与企业决策者来说,这次发布值得记进时间线,但还不构成选型结论。它证明了一件事:把生产级训练栈整体搬到昇腾上是可执行的。它尚未证明的是,这套栈在你的负载、你的集群、你的预算下,跑出来的数字是多少。
文章版权归作者所有,未经允许请勿转载。

