GPT-6通关羊了个羊 大模型推理能力趣味评测
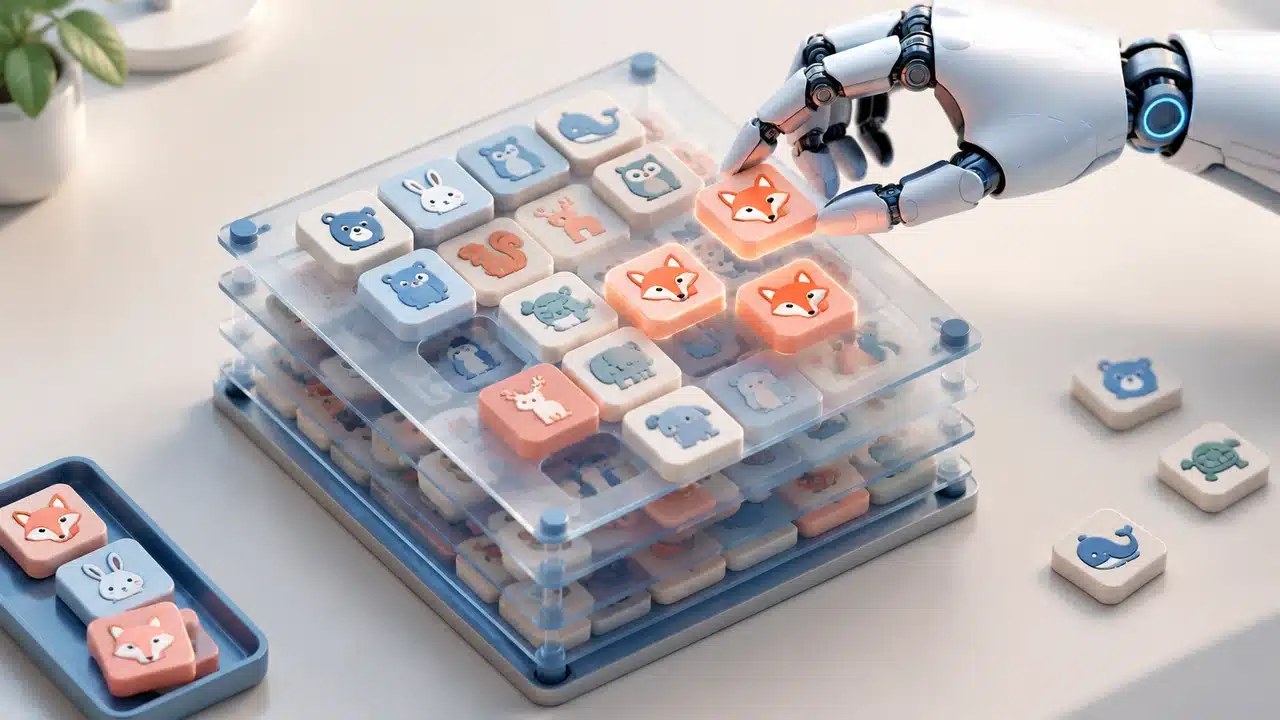
GPT-6 通关《羊了个羊》成为近期 AI 圈最出圈的趣味事件:这款以”史上最难关卡”著称的微信小游戏,被 OpenAI 最新大模型一次拿下,相关演示在哔哩哔哩等平台广泛传播。事件看似娱乐,实则是大模型推理能力的一次全民级压力测试——羊了个羊的第二关以多层堆叠与随机牌面著称,恰好考验模型在信息不完全条件下的规划与试错能力,也让 GPT-6 的推理水准以更直观的方式走进了普通用户视野。
要点速览
- 事件性质:GPT-6 通关《羊了个羊》第二关,趣味推理评测出圈
- 技术看点:多层堆叠消消乐考验长程规划与随机应对能力
- 模型背景:GPT-6 Astra 已大规模推送,网络安全能力达”关键级”
- 传播价值:游戏化评测让复杂推理能力变得可感知、可传播
背景:羊了个羊为什么是”推理试金石”
《羊了个羊》是 2022 年爆火的微信小游戏,玩法是经典三消的变体。玩家需要从多层堆叠的牌面中选取三张相同图案消除,全部消完即为通关。真正让这款游戏”出圈”的是它极低的通关率——第二关的牌面经过特殊设计,堆叠层数与随机分布让大多数玩家反复卡关。
从 AI 视角看,羊了个羊第二关包含三类经典难题:一是信息不完全,玩家只能看到顶层牌面,深层牌面未知;二是长程规划,每一步消除都会影响后续可选项,需要提前预判;三是随机性,牌面分布让纯贪心策略失效。这些特性与真实世界的决策问题高度相似,也让游戏成为比标准基准测试更”接地气”的推理评测场。
过去两年,AI 模型在棋类、电子游戏中的表现一直是能力风向标:从 AlphaGo 击败人类棋手,到各类模型挑战《星际争霸》《我的世界》,游戏始终是检验智能体决策能力的天然沙盒。
关键进展:GPT-6 如何做到”一把过”
GPT-6 通关《羊了个羊》的演示显示,模型并非靠运气,而是展现出明确的推理链条:先观察可消除的顶层组合,规划消除顺序,在出现死局时利用道具与重开策略调整路径。
这一表现与 GPT-6 Astra 的整体能力升级相互印证。素材显示,GPT-6 Astra 已向 Pro、Enterprise 与 Business Premium 用户开放并上线 API,实测中它能依据房源链接在 Blender 里重建三维房屋、直接操作 Chrome 改写 CRM 工作流、把 60 章教材拆成六批组织多智能体协作,网络安全能力达到”关键级”。能通关羊了个羊,本质上是这套规划与试错能力在轻量游戏场景的缩影。
| 能力维度 | 羊了个羊场景体现 | 真实任务对应 |
|---|---|---|
| 长程规划 | 预判消除顺序避免死局 | 项目排期、代码重构 |
| 信息不完全决策 | 基于可见牌面做最优选择 | 交易决策、库存管理 |
| 失败重试 | 死局后调整策略重开 | 自动化测试、智能体任务 |
值得一提的是,通关演示与”一次通过”不同:羊了个羊包含随机因素,模型的强大之处不在于必然通关,而在于能快速识别可解路径、在失败后高效调整,这与真实任务中的 Agent 行为模式一致。
意义:趣味评测为何有价值
传统大模型评测以 MMLU、SWE-bench、BrowseComp 等专业基准为主,结果专业但离普通用户很远。羊了个羊式评测的价值在于把”推理能力”翻译成了人人可感知的语言:大家都能理解”连 AI 都被卡住的游戏,被 GPT-6 通关了”意味着什么。
从行业视角看,这类趣味评测有四个作用。第一,降低认知门槛,让非技术用户直观感受模型进步;第二,暴露真实短板,游戏中的死局往往对应现实中的规划漏洞;第三,推动评测多样性,提醒行业不要把基准分数等同于实际能力;第四,形成传播效应,为技术讨论提供公共话题。
当然,趣味评测也有局限:单一游戏成绩不能代表通用智能,羊了个羊的通关难度也受牌面随机性影响,需要结合专业基准综合判断。
影响:推理能力竞争进入”可见化”阶段
GPT-6 通关羊了个羊的火爆,折射出大模型竞争的一个新趋势:厂商越来越需要把能力优势”演出来”。当参数规模、基准分数无法再简单打动用户,直观的任务演示成为新的营销语言。
对开发者而言,这类演示意味着两件事:一是模型规划能力确实在快速提升,可以放心把更多长链路任务交给智能体;二是评测方法需要更新,除了专业基准,还应加入过程化、交互式的任务验证。对普通用户来说,游戏化评测则提供了一个判断模型”聪明程度”的新坐标。
展望:下一道”羊了个羊”会是什么
GPT-6 通关羊了个羊之后,行业自然会追问:什么样的任务还能难住新一代模型?从能力演进看,下一阶段挑战将来自更复杂的真实世界任务——需要多智能体协作的工程项目、需要长期记忆的科研任务、需要物理常识的机器人操作。
可以预期,未来几个月会有更多”AI 挑战人类经典难题”的演示出现。它们既是技术进步的注脚,也是公众理解 AI 能力边界最直观的窗口。
常见问题(FAQ)
GPT-6 真的通关了羊了个羊吗?
素材显示,GPT-6 通关《羊了个羊》的演示近期在哔哩哔哩等平台广泛传播。模型展现出先观察可消除组合、规划顺序、失败后调整策略的推理链条,被视为大模型规划能力的一次趣味验证。
羊了个羊为什么能测试 AI 推理能力?
羊了个羊第二关包含信息不完全、长程规划与随机性三类难题,与真实决策场景相似,比标准基准测试更直观地反映模型的规划与试错能力。
GPT-6 通关游戏是否代表通用智能?
不能。单一游戏成绩受随机性与场景限制,只能作为推理能力的一个侧面参考,仍需结合 SWE-bench、BrowseComp 等专业基准综合评估。
GPT-6 Astra 目前开放给谁使用?
GPT-6 Astra 已向 Pro、Enterprise 与 Business Premium 用户开放并上线 API,网络安全能力达到”关键级”,支持浏览器操作、三维重建与多智能体协作等复杂任务。
参考资料:素材整理(哔哩哔哩热榜、OpenAI 发布信息、羊了个羊公开玩法信息)。
相关阅读:GPT-6 Astra正式发布:OpenAI自主执行AI模型的突破与影响、Claude完成费马大定理形式化证明:1300万行代码改变数学研究、科大讯飞开源百万词元端侧模型:星火X2.5能力与场景解读
文章版权归作者所有,未经允许请勿转载。

