当你看到“参数量上千亿”的大模型时,可能会产生一个疑问:它每回答一个问题,是否都要把这上千亿个参数完整计算一遍?对于采用混合专家模型(Mixture of Experts,简称 MoE)的模型,答案通常是否定的。它可以把大量参数分成许多“专家”,再由路由机制根据输入内容选择其中少数几个参与计算。
先理解“专家分工”
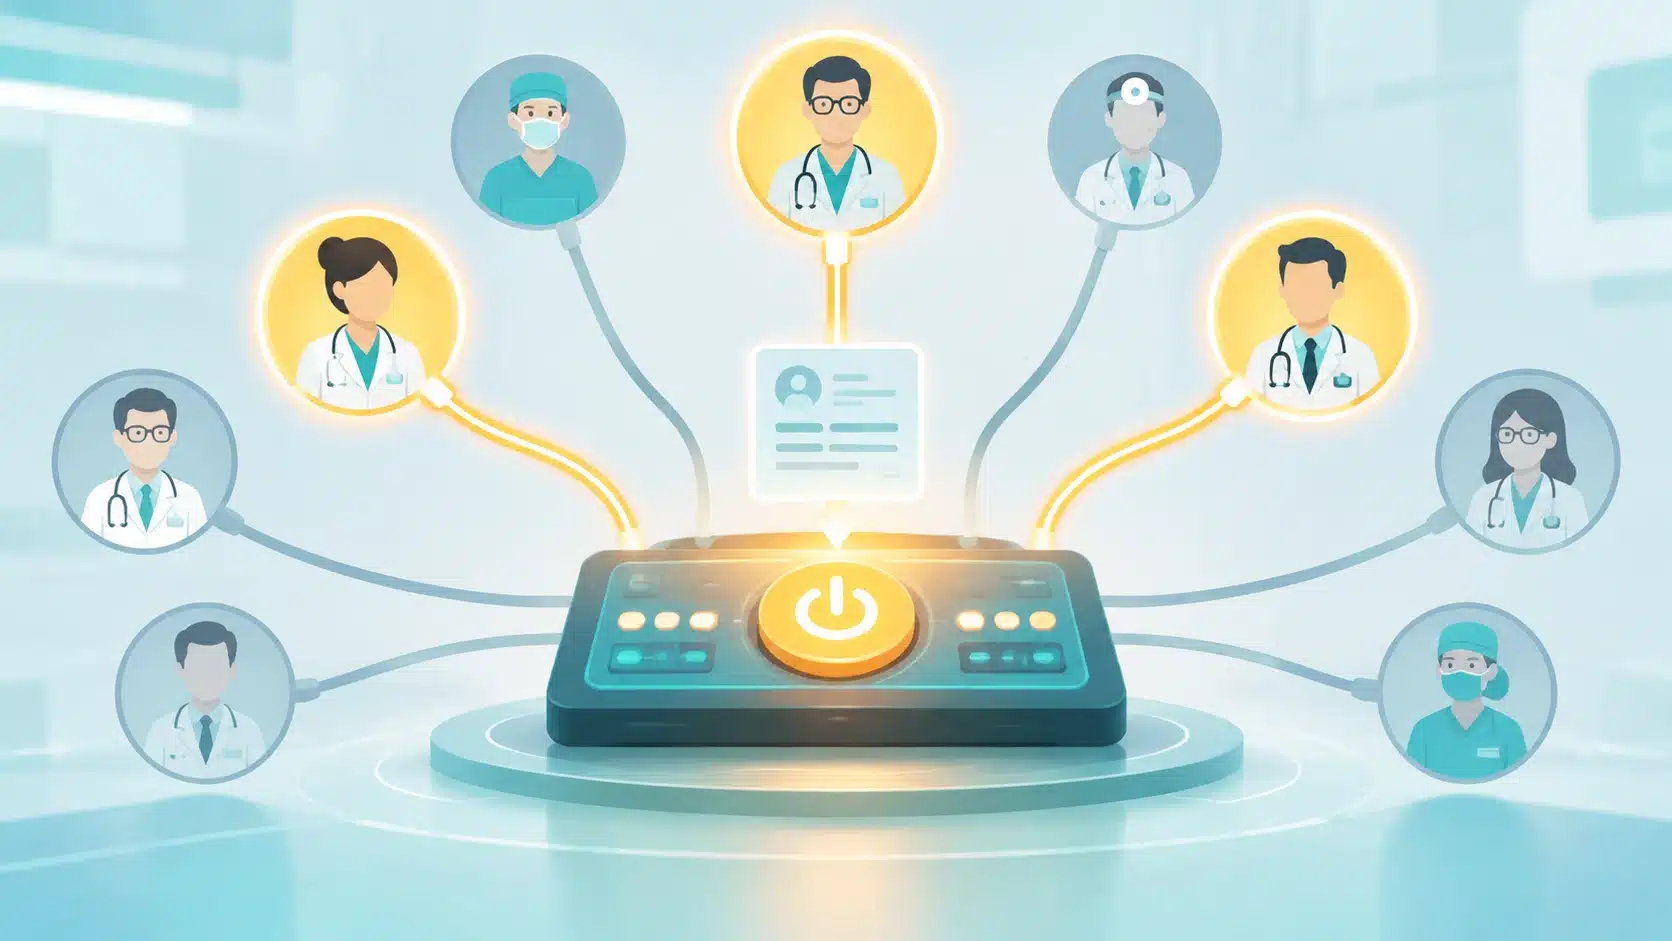
可以把一个 MoE 模型想象成一所拥有许多专科医生的医院。面对一个问题,医院不会让所有医生同时会诊,而是先由“分诊台”判断问题类型,再安排几位最相关的医生处理。
在模型中,这个“分诊台”就是路由器(router),不同的“医生”就是专家(expert)。专家并不是人类意义上的知识专家,而是模型内部的一组神经网络参数。不同专家在训练过程中可能逐渐形成不同的处理倾向,例如更擅长语言表达、知识关联、数学推理或特定模式识别,但它们通常不会被明确标注成某一种能力。
因此,MoE 的核心思想可以概括为:
让模型拥有很多参数,但针对每一个输入,只激活其中一部分参数。
这里的“激活”指的是参与当前输入计算,而不是参数被永久打开或关闭。
路由机制如何选择专家
当一段文字进入 MoE 模型后,路由器会为其中的词元,也就是模型处理的基本文本单位,计算不同专家的匹配分数。随后,模型可以选择得分最高的一个或几个专家,这种方式通常被称为 Top-k 路由。
例如,一个模型有 16 个专家,但每个词元只选择其中 2 个专家处理,那么这次计算主要经过的是被选中的专家,而不是全部 16 个专家。不同词元也可能选择不同的专家,因此一段话内部可能同时调动多个专家。
一个简化流程如下:
- 输入文本被拆分成词元。
- 路由器为每个词元计算专家选择分数。
- 每个词元被分配给一个或多个专家。
- 被选中的专家分别处理这些词元。
- 模型按照路由权重合并专家输出,再继续后续计算。
路由器并不是简单地根据关键词查表。它本身也是模型的一部分,会通过训练学习在什么情况下选择哪些专家。实际系统还要处理专家容量、通信效率和负载均衡等工程问题。
什么是稀疏激活
“稀疏激活”是理解 MoE 的关键概念。
假设一个模型包含 1 万亿个总参数,但每次输入只调用其中约 1000 亿个参数,那么这 1 万亿个参数就是模型的总参数量,1000 亿个则可以近似理解为单次计算涉及的激活参数量。具体比例会因模型结构、统计口径和计算阶段而不同,不能只凭一个数字判断模型性能。
与之相对的是稠密模型(Dense Model)。稠密模型中的主要网络层通常会对每个输入使用同一整套参数。若一个稠密模型有 1000 亿个参数,单次计算通常也要让这套参数整体参与运算。
| 对比项 | 稠密模型 | MoE 模型 |
|---|---|---|
| 参数组织方式 | 所有输入共享同一套主要参数 | 参数分布在多个专家中 |
| 单次激活范围 | 通常接近全部主要参数 | 通常只选择部分专家 |
| 总参数规模 | 扩大后计算成本也明显增加 | 可以在较低单次计算量下扩大 |
| 参数存储需求 | 主要由总参数量决定 | 同样需要存储大量专家参数 |
| 系统复杂度 | 结构相对直接 | 需要路由、通信和负载管理 |
需要注意的是,表格中的“激活参数”并不一定等于一次推理的全部计算量。模型通常还包含共享层、注意力层、嵌入层和输出层,这些部分可能对每个输入都参与计算。因此,激活参数更适合作为理解模型规模和计算特征的一个指标,而不是精确的硬件成本公式。
为什么 MoE 能扩大参数规模
模型参数越多,通常意味着它拥有更大的表示和学习能力,但如果每次都使用全部参数,训练和推理成本也会随之上升。MoE 提供了一种折中方式:
- 用更多专家增加模型的总容量;
- 让每次输入只调用少数专家;
- 通过路由机制把不同输入分配给更合适的计算路径。
这类似于扩大医院的专科数量,但每位患者仍然只需要接受有限几位医生的诊断。医院整体拥有更多专业能力,但单个患者不必让所有科室同时工作。
不过,这种优势并不是“参数免费”。MoE 往往减少的是单次计算量增长速度,而不是所有成本。模型仍然需要保存全部专家参数,训练时还要让不同设备之间交换被分配的词元,推理时也可能需要把请求分发到多个设备。因此,MoE 更准确的特点是“计算稀疏、存储和系统调度复杂”。
总参数和激活参数怎么看
模型发布信息中常见的两个数字是“总参数量”和“激活参数量”。
总参数量表示模型整体包含多少参数,包括所有专家以及共享模块。它更能反映模型需要保存多大的参数集合,也常常影响模型的潜在容量。
激活参数量表示处理一次输入时,大约有多少参数参与主要计算。它更接近单次推理的计算规模,但不同厂商或论文可能采用不同统计方式,因此不能直接把不同模型的数字简单横向比较。
例如,“总参数 1 万亿、激活参数 1000 亿”并不意味着模型在任何情况下都只消耗一个 1000 亿参数模型的资源。实际成本还取决于:
- 每个词元选择多少个专家;
- 是否存在大量共享层;
- 输入长度和输出长度;
- 专家参数是否分布在多台设备上;
- 推理系统是否支持高效的专家调度;
- 训练阶段还是推理阶段。
阅读模型新闻时,最好同时关注总参数量、激活参数量、专家数量、每个词元选择的专家数量,以及测试结果和硬件条件。
MoE 的局限在哪里
路由负载可能不均衡
如果大量词元都被分配给少数几个专家,这些专家就会成为瓶颈,而其他专家处于空闲状态。为此,训练过程通常会加入负载均衡机制,鼓励路由器把输入更均匀地分散到不同专家。
但负载均衡与专家选择之间存在取舍。过度追求均衡,可能让输入被分配给并不理想的专家;过度追求匹配,又可能造成部分专家过载。
显存需求仍然很高
稀疏激活不代表所有参数都可以不存储。推理系统通常仍要准备完整的专家参数,尤其是在模型需要快速响应时,这会带来较高的显存或内存需求。
一些部署方案会把专家参数分布到多张加速卡上,或者在内存与显存之间调度,但这会增加设备间通信和管理复杂度。
专家并不等于清晰的“技能模块”
虽然“数学专家”“语言专家”这样的说法便于理解,但真实模型中的专家分工往往是混合的、动态的,并不一定能被明确解释。一个专家可能同时参与多种任务,多个专家也可能共同完成同一种能力。
因此,不能仅凭专家数量就断言模型拥有多少种独立能力。
激活参数少不等于效果一定更好
MoE 的设计目标是在计算效率、模型容量和效果之间取得平衡,但最终表现仍取决于训练数据、训练方法、路由设计、专家规模和系统实现。一个激活参数较少的模型,不一定比激活参数更多的模型更强;总参数更多,也不自动意味着实际应用效果更好。
记住这几点
混合专家模型可以理解为“总开关加专科医生”:总开关负责路由,专家负责具体计算。它通过稀疏激活,让模型整体拥有大量参数,同时只让部分参数参与每次输入的处理。
阅读相关信息时,可以这样区分:
- 总参数量:模型整体有多大,影响参数存储和潜在容量。
- 激活参数量:一次输入大约调用多少参数,更接近单次计算规模。
- 专家数量:模型把参数分成了多少个专家模块。
- 路由机制:模型如何为不同输入选择专家。
- 实际成本:还要结合显存、通信、输入长度和部署方式判断。
所以,当新闻说某个模型拥有上千亿甚至万亿参数时,不能直接理解为它每次回答问题都要完整计算这些参数。更准确的判断方式,是同时看它采用的是稠密结构还是 MoE 结构,以及公布的总参数量和激活参数量分别是多少。
文章版权归作者所有,未经允许请勿转载。

