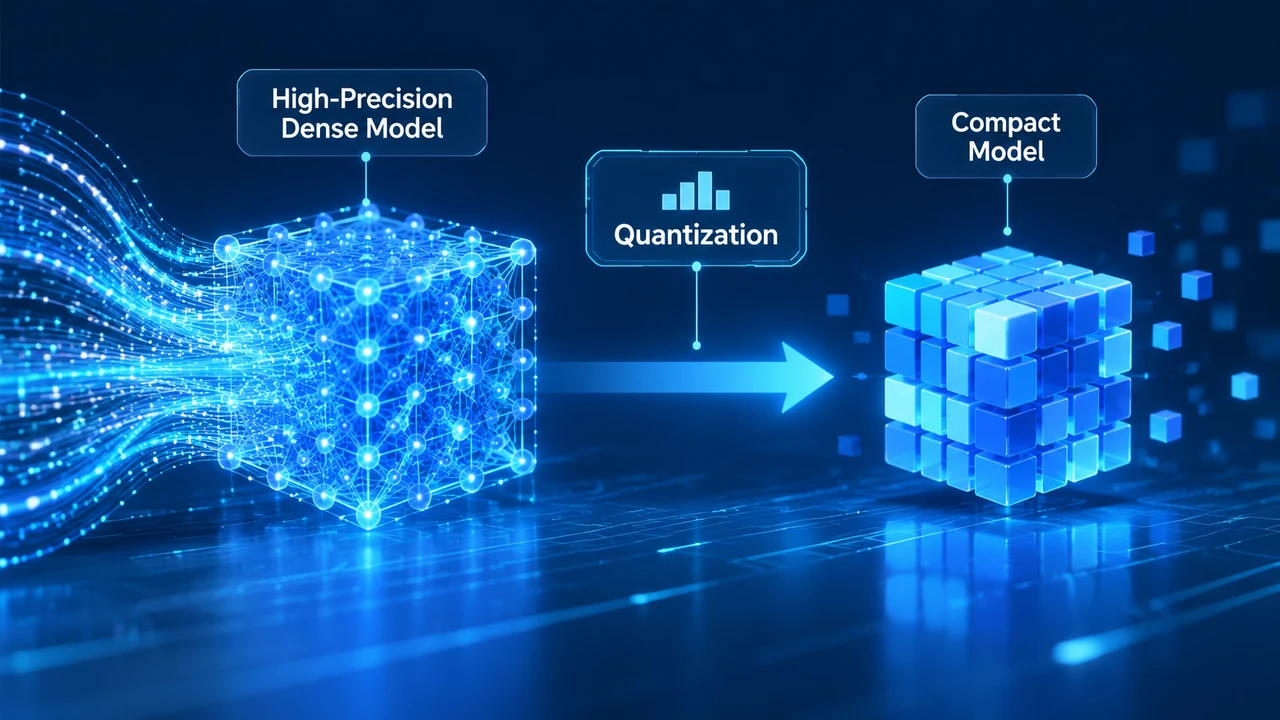
如果把一个拥有数百亿参数的大语言模型比作一本极其厚重的百科全书,那么在没有压缩的情况下,将它完整翻开并流畅阅读,通常需要极其昂贵且专业的服务器硬件。许多团队在尝试落地大模型时,往往会遭遇一道现实的门槛:昂贵的显卡显存装不下模型,或者推算速度太慢、运营成本过高。模型量化(Model Quantization)技术,正是为了解决这一痛点而发展起来的核心工程手段。它就像是一套精准的“数学缩句法”,通过降低计算与存储的精度,让大模型在几乎不损失理解能力的前提下实现大幅瘦身。
从生活类比理解“精度”:尺子上的刻度
要理解模型量化,首先需要弄清楚什么是“精度”。
在日常生活中,如果有人问你现在的室外气温是多少,你通常会回答“23度”或者“23.5度”,这就足以满足出行穿衣的判断需求。除非是在精密的科研实验室,否则没有人会报出“23.478291度”这样一个极度精确的数字。
计算机在表示数据时也是同样的道理。在训练一个人工智能模型时,为了捕捉数据中微弱的信号,计算机通常采用“高精度浮点数”,例如32位浮点数(FP32)或16位半精度浮点数(FP16)。一个FP32格式的数字,就像是用一把精确到纳米级的标尺在量尺寸;而低精度计算(如8位整数INT8,甚至4位整数INT4),则相当于换成了一把刻度更粗糙、但完全够用的普通米尺。
模型量化的本质,就是把模型中成百上千亿个用“纳米级标尺”记录的参数,按照特定规则映射并转换为更短、更简洁的“粗颗粒度数值”。
常见的数值格式:FP16、INT8 与 INT4
在关注模型部署或阅读硬件配置要求时,经常会看到几种代表精度的英文缩写,它们决定了模型占用空间的大小:
| 格式名称 | 数据类型 | 每个参数占用显存 | 特点与应用场景 |
|---|---|---|---|
| FP16 / BF16 | 16位浮点数 | 2 字节(Bytes) | 现代大模型训练与原生输出的标准格式,精度高但资源消耗大 |
| INT8 | 8位整数 | 1 字节(Byte) | 经典量化标准,体积缩小约一半,推理速度明显提升,精度几乎无损 |
| INT4 | 4位整数 | 0.5 字节(Nibble) | 极致压缩,体积缩至原模型的四分之一,适合显存极度受限的场景 |
简单换算即可发现:一个拥有700亿参数(70B)的模型,在FP16格式下仅存放权重参数就需要消耗约140GB的显存,必须使用两张昂贵的专业计算卡才能装载运行。但如果将该模型量化为INT4格式,参数体积将骤降至35GB左右,在单张高端消费级显卡甚至高配笔记本电脑上,便具备了运行的基础可能。
量化带来的核心收益:显存优化与计算加速
模型量化为工程落地带来了立竿见影的效益,主要集中在以下三个方面:
1. 显存占用的断崖式下降
正如上述计算所示,显存优化是量化最直接的收益。显存是GPU上最昂贵也是最紧张的资源。通过大幅压缩权重体积,不仅原本无法运行的大模型可以加载进单卡,还可以为并发处理用户请求预留出更多缓存空间。
2. 内存带宽压力释放与推理加速
在大语言模型的推理阶段,主要的性能瓶颈往往不是处理器的纯计算能力,而是“把权重数据从显存搬运到计算单元”的传输速度(即内存带宽)。当模型体积被压缩为原本的四分之一甚至更小时,每次搬运的数据量成倍减少,从而直接提升了生成回复的速度。
3. 计算单元的能耗降低
相比复杂的浮点乘除运算,整数(INT)运算在硬件底层所需的晶体管数量更少,功耗也更低。这意味着在同样的时间内,硬件可以执行更多次计算,并且发热量与电费开销都更小。
性能与精度的权衡:量化会变“笨”吗?
很多产品人员和技术评估者最关心的问题是:给数字降精度,模型的智商是否会明显缩水?
答案取决于压缩的深度与采用的量化算法。
- INT8量化:接近“免费的午餐”
在大多数成熟的量化方案中,将模型从FP16压缩至INT8,在绝大多数常识问答、文本总结、代码补全等基准测试中,性能损失通常在1%以内,人类在实际使用中很难感知到差异。
- INT4量化:特定场景下的微调权衡
在进一步压榨空间降至INT4时,模型的通用逻辑推理、长链路复杂计算或极端精细的数学推导能力可能会出现可观测的波动。但针对特定领域的专业对话、日常客服以及轻量级交互,INT4版本的表现依然高度可用。
为了尽可能减小精度的损失,工程界发展出了多种量化技术。一种是训练后量化(PTQ),即模型训练完成后直接通过统计分析进行转换,操作快捷、成本低;另一种是量化感知训练(QAT),在模型训练的最后阶段就模拟低精度的误差,让模型在调整权重时主动适应这种粗糙度,从而在极低精度下依然保持极高的稳定性。
适用场景边界与总结
模型量化并非在所有环节都适用。在模型的训练阶段,由于需要累积极其微小的梯度调整,浮点数的高精度仍然必不可少,量化主要发生在模型推理与部署阶段。
对于业务实践而言,量化是实现AI从云端走向边缘计算(如在智能座舱、个人电脑、手机及工业设备上本地运行模型)的关键前置条件。同时,在云端高并发服务中,它也是大幅压降服务器采购成本和电费成本的有效工具。
归纳起来,理解模型量化只需把握三个核心结论:
- 量化是降精度而非删结构:模型层数和参数逻辑没有变,只是每个数字用更短的单位来存储和计算。
- 显存和带宽是主要收益点:量化有效打破了硬件显存墙,加快了推理输出速度。
- 适度量化收益远大于损失:在INT8乃至经过良好优化的INT4下,以极小的生成质量妥协换取成倍的部署成本下降,是当前大模型规模化商用中最基础且实用的工程实践。
文章版权归作者所有,未经允许请勿转载。

