大模型生成文本时,通常要等前一个词元确定,才能计算下一个词元。对交互式服务来说,这种串行过程会拉长用户等待完整回答的时间。推测解码试图减少目标模型参与的串行轮次:让计算成本较低的草稿模型先提出一段候选续写,再由负责最终输出的目标模型集中验证。它能否加速,取决于一次验证能确认多少词元,以及草拟和验证本身要付出多少成本。
为什么一次验证可能比逐个生成更快
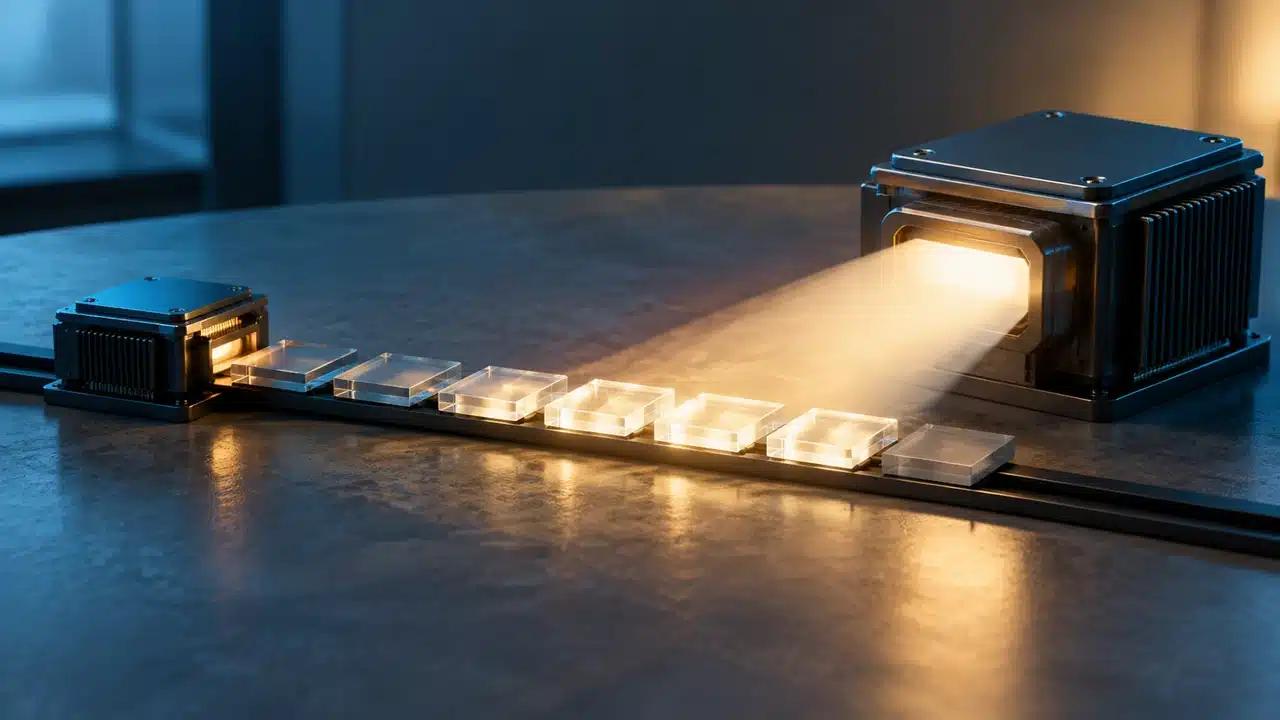
常规解码中,目标模型每生成一个词元,就要执行一次前向计算。推测解码则让草稿模型连续提出若干候选词元;目标模型随后利用因果注意力,在一次前向计算中评估这些候选位置。这里的“并行”不是说后面的词元不依赖前文,而是说候选序列已给定,目标模型可以同时计算各位置在相应前缀下的预测分布。
如果候选序列的前几位都获得认可,目标模型一次验证就能推进多个词元。尤其在小批量、生成阶段受模型权重读取等开销制约时,验证多个位置可能比反复启动多次目标模型计算更划算。但验证并非免费,也不能假定它与生成一个词元耗时相同。
草稿与目标模型怎样协作
一次典型的推测解码循环可以拆成四步:
- 草拟:草稿模型根据当前已确认的上下文,依次生成一段候选词元,并记录各位置的预测分布。
- 验证:目标模型处理这段候选序列,计算每个候选位置对应的目标分布。
- 接受或拒绝:从第一个候选词元开始,按所采用的验证规则依次判断。遇到首次拒绝时,后续候选不能直接沿用,因为它们建立在未被接受的前缀上。
- 继续生成:系统保留已接受的前缀,确定下一个词元,并以新的已确认上下文开始下一轮。
验证规则决定了“加速但不改变目标模型输出分布”能否成立。以标准随机采样方案为例,候选词元按目标模型与草稿模型赋予它的概率之比接受;发生拒绝时,再从经过修正的分布中采样,而不是简单让目标模型重新抽一个词元。贪心解码有相应的确定性校验方式。只有采样设置和验证算法正确匹配时,才能谈得上保持目标模型原有的生成分布;草稿模型的答案不会因为“看起来合理”就自动成为最终答案。
收益取决于接受率,也取决于额外开销
草稿模型越接近目标模型在当前任务上的预测,连续候选被接受的机会通常越高,一轮验证就越可能推进较长的输出。但草稿模型也必须足够快:如果它为提出候选花费太久,即使接受率不错,也可能抵消收益。候选长度同样需要取舍——提得太少,摊薄不了目标模型的调用开销;提得太多,被拒绝后的无效计算和验证成本会增加。
评估时应区分首词元延迟、生成阶段的词元间延迟和整体吞吐量。推测解码主要针对生成阶段的串行瓶颈,不能把它在某种负载下改善词元间延迟的结果,直接推断为长提示词的首词元延迟也会改善。硬件计算能力与显存带宽、请求长度、并发批量、输出长度以及业务内容的可预测性,都会改变结果。高并发服务中,目标模型原本可能已通过批处理充分利用硬件,此时额外的草拟步骤未必划算。
部署时还要付出什么
采用独立草稿模型,通常意味着额外的模型权重、运行时状态和 KV 缓存占用;目标模型也需要为候选验证、缓存保留或回退安排资源。草稿与目标模型还需具备兼容的词元表示和可对齐的概率信息,否则验证难以按预期进行。服务框架则要协调两套计算、处理拒绝后的缓存状态,并避免调度开销吞掉省下的时间。这些因素会同时影响显存与延迟,而不只是增加一道算法步骤。
因此,是否启用推测解码不宜只看单次演示的加速比。更可靠的做法是在目标硬件上,用真实请求的提示词长度、输出长度和并发分布测试接受率、延迟分位数、吞吐量及显存占用。它的价值在于用较便宜的预测换取更少的目标模型串行轮次;只有节省超过草拟、验证和调度的总成本时,这笔交换才成立。
文章版权归作者所有,未经允许请勿转载。

