当AI服务从实验性工具进入订单处理、客服、风控、代码生成等核心链路后,中断不再只是“模型暂时不可用”的技术问题,而可能转化为业务停滞、客户投诉与合规风险。近期大模型API和智能体平台的稳定性波动,让企业采购团队把评审重点从模型榜单、参数规模和单价,转向SLA口径、故障通知、灾备降级与人工接管边界。企业需要的不是一个永远不宕机的承诺,而是一套中断发生前可核验、发生时能执行、发生后可追责的可靠性体系。
从模型能力转向服务承诺
核验SLA:先问清“可用性”怎么算
企业采购中常见的“99.9%可用性”,按每月约30.42天粗算,对应约43.8分钟不可用时间;99.95%约为21.9分钟;99.99%约为4.38分钟。数字本身不是重点,重点在于供应商是否明确统计范围:计划内维护是否算入不可用、只统计模型推理还是包含API网关、排队与向量检索等完整链路,以及故障时长按分钟、按请求还是按业务影响计算。如果SLA只覆盖模型推理成功返回,而前置网关或限流故障被排除,实际可用性可能远低于合同表面数字。
| SLA 可用性 | 每月不可用时间(约) |
|---|---|
| 99.9% | 43.8分钟 |
| 99.95% | 21.9分钟 |
| 99.99% | 4.38分钟 |
故障通知与恢复承诺要写进条款
企业应要求供应商在采购阶段明确:故障分级标准、不同等级的通知时限、状态页更新频率、预计恢复时间,以及事故后是否提供可核验的复盘报告。通知不应只是事后公告,而应成为服务等级的一部分。对关键业务,还需约定RTO和RPO:恢复时间目标决定多久能切回,数据或会话状态目标决定切换后业务能否连续。两者若只停留在口头承诺中,正式合同里没有,一旦发生中断就很难追责。
灾备与降级:不把单一API当作唯一依赖
单一供应商无论SLA多高,都不能替代灾备设计。企业可按业务重要性分层:对核心交易链路,采用多供应商路由、本地小模型兜底、缓存常见响应或降级到规则模板;对非关键环节,可接受排队、重试和延迟。关键不是所有请求都必须实时回答,而是系统在AI不可用时仍能保持最小可用。灾备方案需要在正常时段演练,而不是等中断发生时临时拼凑。
人工接管与权限边界
AI代理在企业系统中的权限越大,中断或被操纵时的风险越高。写入、删除、付款、外发等高风险操作应默认人工复核或二次确认,自动执行范围要有明确边界。人工接管不是“所有任务转人工”,而是提前定义哪些流程可以暂停、哪些可以降级、哪些必须由授权人员介入。对供应商的权限设计、审计日志和操作回滚能力,也应纳入选型评估。
影响选型:合同条款与运营能力同等重要
采购团队过去更关注模型能力,现在需要法务、安全、运维和业务方共同评审可靠性条款。可以问供应商:是否公开历史可用性记录;是否提供故障复盘;赔付机制是否与实际业务损失匹配;在服务中断、模型下线或版本变更时,是否提前通知并提供迁移窗口。英博数科副总经理宋琛在行业会议上提到,AI基础设施的竞争重点正在从算力规模转向算力运营,客户关心的问题变得更具体。这一判断与采购端变化方向一致:企业不再只看供应商建了多少算力,更看它能否把服务承诺、故障响应和降级路径管理清楚。AI可靠性的评估因此从模型输出质量延伸为对服务全链路的治理能力。
后续观察:从一次性采购转向持续可靠性管理
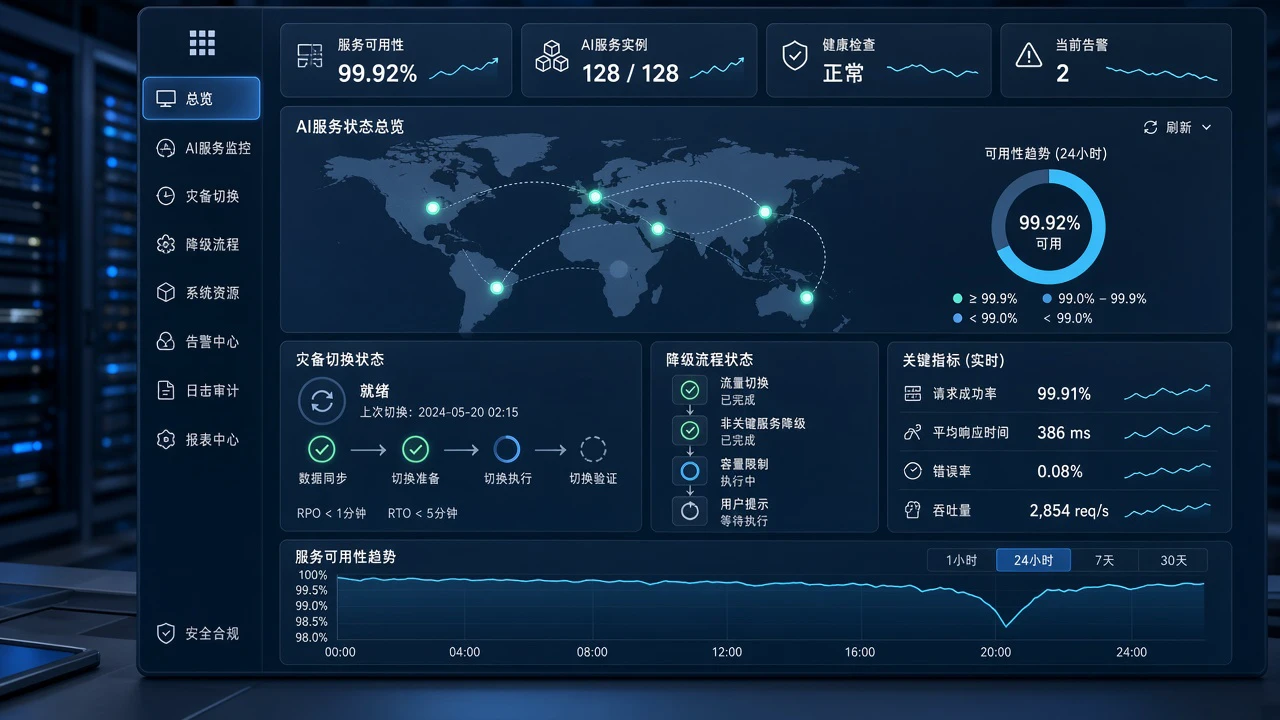
未来一段时间,AI服务稳定性会继续面临模型迭代、算力调度和流量高峰的多重压力。企业可建立内部监控看板,记录各供应商实际可用性、故障次数、通知延迟和恢复时间,用真实运行数据替代供应商宣传。也值得观察行业是否会形成更统一的SLA审计标准,以及监管是否会对关键场景中的AI依赖提出更明确的连续性要求。在此之前,把“不可用之后怎么办”写进采购条款,比单纯比较模型分数更接近生产级决策。
文章版权归作者所有,未经允许请勿转载。

