多模型协同架构:Gemini如何扮演导演角色
谷歌发布新一代世界模型Genie 4:音画同步与实时交互落地,多模态协同带来哪些新信号
Genie 4的发布之所以值得关注,不只是因为画面更逼真,而是它的架构逻辑发生了根本变化。过去以Sora、Runway为代表的视频生成模型,本质上是“一次出片、成片定型”,用户输入提示词后得到一段高清视频,只能被动观看,无法干预画面走向。Genie 4则打破了这层“屏幕壁垒”,用户可以在生成的世界中实时漫游、改变天气、添加角色,甚至改变故事走向。它更像一个可实时操控的模拟器,而非一段定型的影像。这种从“放电影”到“搭世界”的转变,背后依赖的正是多模型协同的架构设计。
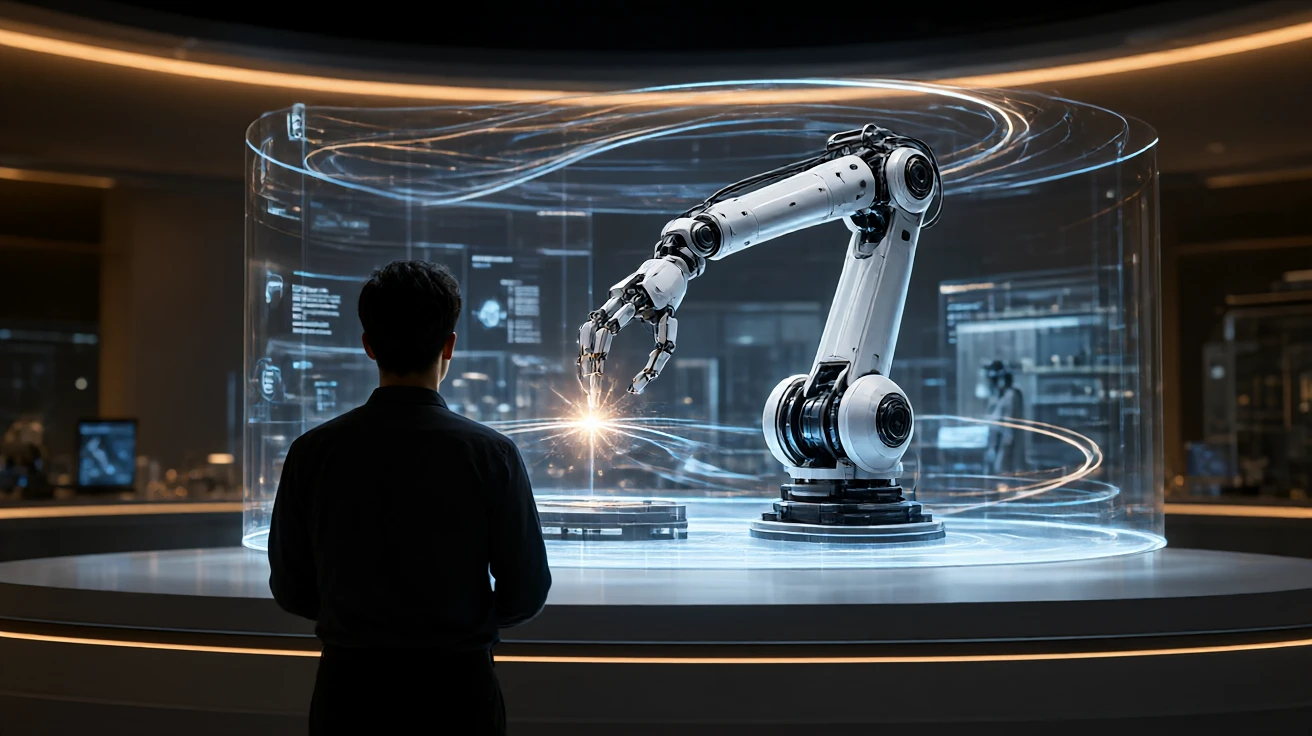
理解这套架构,关键要抓住“导演”这个隐喻。DeepMind将Gemini模型体系嵌入Genie 4的运转流程,形成了“生成器+规划器+审核器”的分工模式。其中Gemini Omni负责锚定世界的视觉外观与行为逻辑,相当于搭建舞台和布景;Gemini 3.8 Flash则作为“回路中的智能体”,观察场景、拆解目标并逐帧校验任务步骤是否完成,扮演的是现场导演和执行监制的角色。这种分工的价值在于,世界模型不再只是被动响应指令,而是具备了目标拆解和过程校验的能力。一个典型的演示场景是虚拟实验室中的机械臂操作:从任务步骤规划到模拟精细动作,整个过程都在AI生成的环境中进行,旁边还能实时显示推理步骤。这意味着Genie 4不仅会“造画面”,还能理解任务逻辑并推演执行路径。
这种“导演”机制解决的核心问题,是实时交互带来的失控风险。当用户随时修改天气、增减物体、控制角色动作时,模型必须持续判断“当前画面是否符合物理规律”“任务步骤是否完成”“下一步该生成什么”。如果没有一个独立的规划与审核模块,仅靠单一生成模型很难保持长时间的场景一致性。Genie 4将场景一致性从Genie 3的约1分钟提升至2分钟,正是这种多模型协同在长时程稳定性上的直接体现。值得注意的是,DeepMind也坦承Genie 4仍处于研究预览阶段,存在细节和物体永久性漂移、可读文本和音频准确性不足等限制,所有生成的视频和音频均带有SynthID水印。
从行业信号看,世界模型的竞争焦点正在从“画面像不像”转向“物理对不对、响应快不快、落地稳不稳”。国产厂商X-Era AI拓元智慧近期开源的4D世界动作模型E0.5,在双臂机器人和人形机器人真机任务中,整体平均成功率分别达到85.0%和88.3%,较主流基线π0.5高出13.3和26.7个百分点。智元机器人稚晖君则指出,很多跳舞机器人本质上仍是“闭着眼睛的动作模仿”,实时感知响应无法靠遥控器实现。两条线索指向同一判断:世界模型正在成为机器人训练和场景预演的可操作仿真环境,而非单纯的视频生成工具。
当然,Genie 4的算力消耗与部署成本仍是现实约束,研究预览版的定位意味着其距离稳定、低成本、可大规模部署的物理AI基础设施仍有距离。但谷歌此次将音画同步、实时交互与多模型协同整合进一个框架,确实为世界模型的实用化划定了一条更清晰的路径。后续值得观察的是,Genie 4的交互能力能否在更大规模场景中保持一致性,以及Gemini主导的“导演”机制能否有效降低复杂任务的推理成本。
文章版权归作者所有,未经允许请勿转载。
本文链接:https://www.chatcpt.com.cn/thread/gemini-director-role/
参与讨论
暂无评论,快来发表你的观点吧!