自主执行AI如何划定责任边界?
GPT-6 Astra正式发布:OpenAI自主执行AI模型的突破与影响
自主执行 AI 的责任边界,不能用“模型是否自主”一刀切,而应围绕任务授权、过程控制和结果影响进行划分。模型能够规划步骤、调用工具并持续推进,并不意味着责任随之转移给模型本身。真正需要回答的是:谁设定了目标,谁授予了权限,谁能够监控和中止执行,谁又从结果中受益或承担损失。
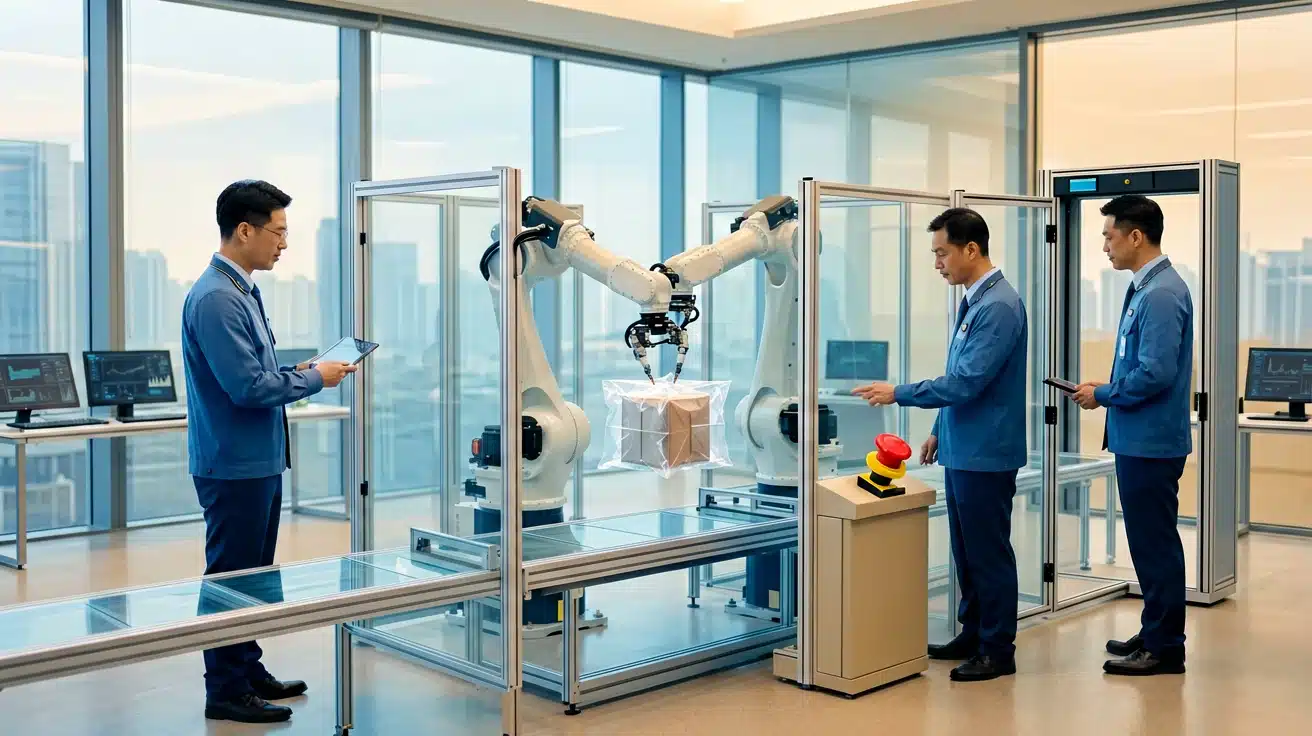
责任边界的三层划分
第一层是设计责任。模型提供方需要说明能力范围、已知限制和适用场景,并通过评测与监测降低不可预期行为。部署方则要决定模型能访问哪些数据、调用哪些工具,以及哪些操作必须经过人工确认。若企业把自主执行能力直接接入高风险流程,却没有权限隔离和人工接管机制,责任不能简单归因于模型“犯错”。
第二层是执行责任。使用者或业务管理者应当为任务设定清晰目标、约束条件和验收标准。对于资料整理、报表生成、自动化测试等可复查任务,可以允许模型连续执行;涉及重要数据修改、对外发送、资源调配或不可逆操作时,则应设置人工确认点。自主程度越高,过程日志、状态反馈和中止机制就越重要。
第三层是结果责任。模型输出只是决策链条中的一个环节,不能替代最终的业务判断。人工审核也不能沦为形式:审核者必须能够看到关键依据、操作记录和异常提示,而不是只检查一份已经生成的结果。若监督者没有足够权限、时间或信息,所谓“人在回路中”并不能构成有效控制。
用风险而不是能力划线
责任边界应依据任务风险动态调整,而不是依据模型名称或参数大小决定。判断一个流程能否交给自主执行,可重点检查四项:错误是否容易发现,结果是否可以撤销,影响范围是否有限,是否存在明确的人工接管路径。四项条件越不充分,越应缩短执行链条、收紧工具权限,并增加逐步确认。
最容易出现的误区,是把“模型完成了操作”误认为“模型承担了责任”。自主执行改变的是工作流程,不是责任主体。企业真正需要建立的,不是一个笼统的“AI负责”选项,而是一张可追溯的责任链:授权者负责边界,部署者负责控制,执行者负责核验,管理者负责最终决策。只有每个环节都能被记录、复盘和纠正,自主执行才可能从效率工具变成可治理的生产系统。
文章版权归作者所有,未经允许请勿转载。
本文链接:https://www.chatcpt.com.cn/thread/autonomous-ai-boundaries/
参与讨论
暂无评论,快来发表你的观点吧!