数据积累为何成为智能质检的护城河
TOPIC SOURCE
AI质检在3C电子产线落地:缺陷检出率从93%跃升至99.7%的实战拆解
智能质检的护城河,不是“存了多少图片”,而是能否把图片转化为稳定、可复用的判断能力。缺陷样本必须与成像条件、缺陷类别和判定标准对应起来;如果光照变化、标注口径不一,或正常样本远多于罕见缺陷样本,数据规模再大,也未必能让模型更可靠。
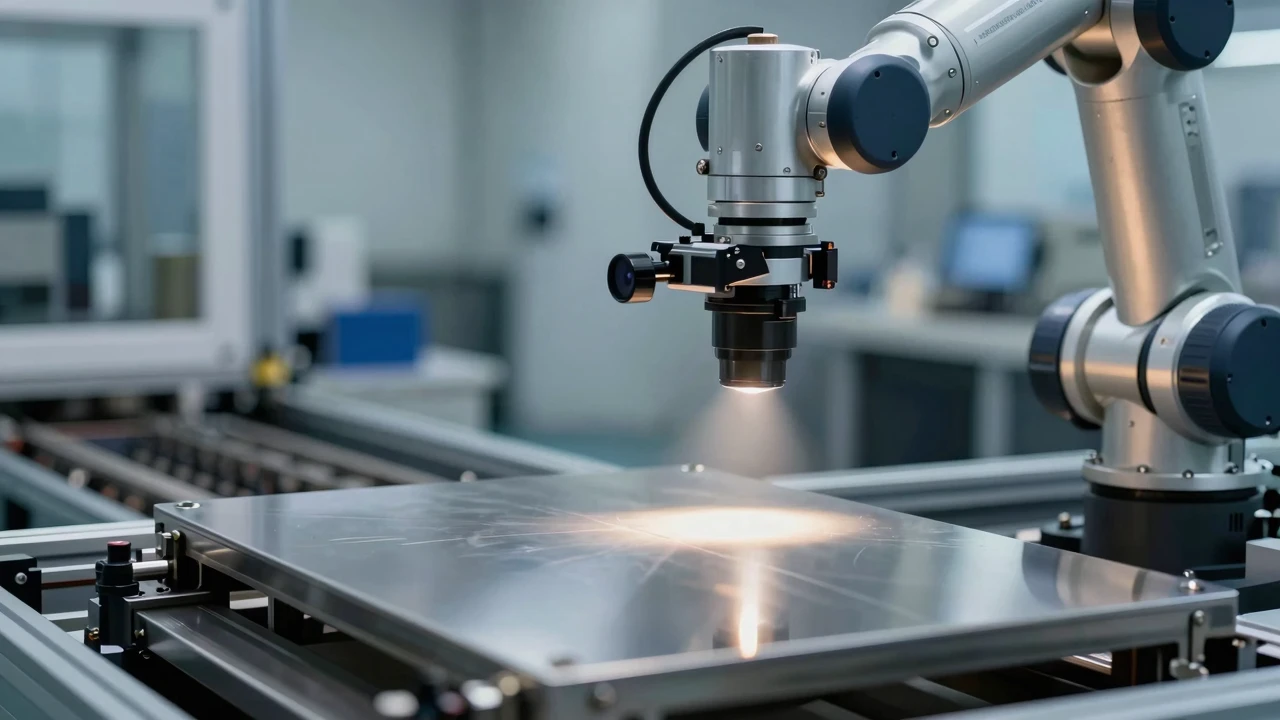
数据积累的价值,首先体现在覆盖缺陷边界。常见划痕容易采集,真正影响检出能力的,往往是少见、细微、形态多变的缺陷。现场质检员对疑难样本的复核和分类,能不断补足缺陷库;不同角度、光照下采集的图像,则帮助模型区分真实缺陷与成像干扰。数据因此不是一次性交付物,而是随产线运行持续修正的生产资产。
更关键的是,检测结果若能关联缺陷类型、位置和批次,就不只用于判断单件产品是否合格,还能帮助识别缺陷集中出现的工位或批次,让质检信息反向服务工艺改进。随着反馈积累,企业获得的不只是更丰富的样本,也包括更贴近自身产品与生产条件的判定经验。
这构成了数据壁垒的累积效应:新产线可以采购相似设备和算法,却不能立即复制已有的标注规范、疑难样本和现场反馈。数据迁移也并非简单复制;产品形态、光学条件和产线标准化程度不同,都可能要求重新采集、补充标注和调整模型。因此,数据护城河并非天然存在,而是由稳定采集、可信标注和持续闭环共同形成。企业若只追求图片数量,却不治理质量与场景差异,积累的可能只是存储成本,而非竞争优势。
文章版权归作者所有,未经允许请勿转载。
本文链接:https://www.chatcpt.com.cn/thread/data-moat-inspection/
参与讨论
暂无评论,快来发表你的观点吧!